Observational Memory
新增于: @mastra/memory@1.1.0
Observational Memory(OM)是 Mastra 面向长上下文 agentic 记忆的记忆系统。后台 agent(Observer 和 Reflector)会观察你的 agent 对话,并维护一份密集的观察日志;随着日志增长,它会取代原始消息历史。
快速开始快速开始的直接链接
确保项目中已安装 @mastra/memory。在 Memory 配置中设置 observationalMemory: true 即可启用 Observational Memory。
import { Memory } from '@mastra/memory'
import { Agent } from '@mastra/core/agent'

export const agent = new Agent({
  id: 'my-agent',
  name: 'my-agent',
  instructions: 'You are a helpful assistant.',
  model: 'openai/gpt-5-mini',
  memory: new Memory({
    options: {
      observationalMemory: true,
    },
  }),
})
现在,agent 拥有了类似人类的长期记忆,可以跨对话持久保留。设置 observationalMemory: true 会使用自动模型选择。要使用特定模型,请在配置对象中传入:
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'deepseek/deepseek-reasoner',
    },
  },
})
完整的 API 细节请参阅配置选项。
在客户端应用中使用 OM 时,客户端应只发送新消息,而不是完整的对话历史。
Observational Memory 仍然依赖已存储的对话历史。发送完整历史是多余的,并且当客户端时间戳与存储的时间戳冲突时,可能导致消息顺序错误。Mastra 会在加载已存储消息前过滤客户端回传的历史,并在消息 ID 匹配时以存储的副本为基础,保留存储的时间戳和提供商元数据,同时保留新的工具结果。
如果你自行组装请求输入且需要按原样处理,请在该次调用的 memory.options 中设置 retainFullInput: true,或在 memory 构造函数选项中设置以应用到整个 agent。这会禁用该过滤。历史仍会在底层加载。每条尚未存储的输入消息都会保存到 thread,包括 few-shot 示例。
AI SDK 示例请参阅使用 Mastra Memory。
OM 目前仅支持 @mastra/pg、@mastra/libsql、@mastra/mysql、@mastra/mongodb、@mastra/convex 和 @mastra/oracledb 存储适配器。
它使用后台 agent 管理记忆。未设置模型时,默认为 model: 'auto'。
Mastra Code 和 Factory 中的自动模型Mastra Code 和 Factory 中的自动模型的直接链接
Mastra Code 和 Factory 在其设置中以按角色的 Auto 选项呈现相同的自动选择。
自动的 Observer 或 Reflector 会跟随当前主模型的提供商。Mastra Code 会在配置了内置低成本 Observational Memory 模型时使用该提供商的模型。对于自定义提供商和没有内置选择的提供商,则使用当前主模型。实际生效的模型在该角色运行时解析,因此更改主模型不会重写已保存的自动选择。
选择显式模型可以独立固定某个角色。将该角色重置为 Auto 可恢复跟随主模型提供商。已保存的具体模型 ID 在你重置它们之前会保持显式。
Factory 将自动意图与设置中显示的实际生效模型分开存储。缺少提供商凭证可能会将实际生效模型标记为不可用,但不会替换已保存的选择,也不会阻止 Factory 启动。
时间间隔标记时间间隔标记的直接链接
当 thread 中距上一条消息已过去足够长时间时,时间间隔标记会在新的用户消息前插入一条简短提醒。它们帮助 agent 和 UI 看到对话是在一段有意义的暂停后恢复的。
时间间隔标记默认关闭。在 observationalMemory 配置中通过 temporalMarkers: true 启用:
import { Memory } from '@mastra/memory'
import { Agent } from '@mastra/core/agent'

export const agent = new Agent({
  id: 'my-agent',
  name: 'my-agent',
  instructions: 'You are a helpful assistant.',
  model: 'openai/gpt-5-mini',
  memory: new Memory({
    options: {
      observationalMemory: {
        model: 'google/gemini-2.5-flash',
        temporalMarkers: true,
      },
    },
  }),
})
当间隔至少为 10 分钟时,Mastra 会插入时间间隔标记。该标记存储在记忆中,同时作为瞬态提醒事件发出,因此客户端可以将其渲染为轻量的时间线提示。
Observer 在处理 thread 时也会看到这些标记。它写入的观察记录可以将记忆锚定到事件发生的时间(例如"用户在 2 天间隔后询问了部署问题")。
完整的配置结构请参阅 API 参考。
提前激活提前激活的直接链接
OM 可以在达到 token 阈值之前激活已缓冲的观察记录。当 prompt 缓存可能即将过期,或 agent 更换模型提供商时,这非常有用。
顶层提前激活设置默认适用于观察记录:
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      activateAfterIdle: 'auto',
      activateOnProviderChange: true,
    },
  },
})
使用嵌套的 observation 和 reflection 设置进行按阶段控制。Reflection 的提前激活需要主动启用,因此顶层设置只影响观察记录。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      activateAfterIdle: '5m',
      observation: {
        activateAfterIdle: false,
      },
      reflection: {
        activateAfterIdle: '10m',
        activateOnProviderChange: true,
      },
    },
  },
})
在此示例中,顶层空闲设置对观察记录被禁用,而 reflection 选择启用空闲和提供商变更激活。
空闲时缓冲空闲时缓冲的直接链接
将 observation.bufferOnIdle 设置为 true,可在 agent 回合结束并进入空闲时运行后台观察缓冲。这适用于希望短回合也能被观察、而无需等待下一回合或 messageTokens 阈值的应用。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'openai/gpt-5-mini',
      observation: {
        bufferOnIdle: true,
      },
    },
  },
})
bufferOnIdle 默认关闭。它与 bufferTokens 不同:bufferTokens 控制步骤时的异步缓冲,而 bufferOnIdle 控制空闲回合的回合结束时缓冲。
重试与失败策略重试与失败策略的直接链接
Observer 和 Reflector 的模型调用会对瞬态提供商错误进行重试。默认情况下,仍失败的同步观察或 reflection 会中止该回合。每个阶段由以下选项独立控制:
maxRetries:初始模型调用之后的重试次数(默认8)。failurePolicy:重试耗尽后的行为,可选'abort'(默认)或'continue'。
const memory = new Memory({
  options: {
    observationalMemory: {
      observation: {
        maxRetries: 8,
        failurePolicy: 'continue',
      },
      reflection: {
        maxRetries: 8,
        failurePolicy: 'continue',
      },
    },
  },
})
maxRetries 管控 OM 自身的重试阶梯;底层模型调用未配置提供商级重试,因此该选项是该阶段唯一的重试开关。
使用 failurePolicy: 'continue' 时,Mastra 会按配置重试,通过现有的 OM 诊断报告失败,将失败的输入保留为待处理以便稍后周期处理,并让主 agent 回合继续进行。它不会推进观察边界或丢弃未观察的消息。在 'continue' 下 Reflector 失败时,已持久化的观察记录保持提交状态,reflection 推迟到下一次达到阈值时进行。
提供商故障通常会同时影响两个阶段,如果你希望回合能挺过一次故障,请为两个阶段都设置该策略。
该策略仅适用于观察或 reflection 同步运行时的 Observer 和 Reflector 模型及提供商故障:在 blockAfter 处、禁用异步缓冲时以及 resource 作用域观察中。在这些路径中,持久化、索引、transform、锁、不变量检查和显式中止的失败仍然是致命的。它不会阻止底层的提供商或网络错误,不会更改 blockAfter,也不会改变附件处理方式。
后台(异步缓冲)观察和 reflection 失败无论策略如何都不会停止回合。它们会被报告为 om_buffering_failed,失败的输入保持待处理。如果持续增长并达到 blockAfter,同步观察将应用 failurePolicy。
'continue' 对持续故障没有兜底措施。未观察的消息会一直待处理,并持续累积在主 agent 的上下文中。
长时间故障会将问题从记忆层转移到模型的上下文限制。
完整的配置结构请参阅 API 参考。
优势优势的直接链接
- Prompt 缓存:OM 的上下文稳定,观察记录随时间追加,而不是在运行时每回合检索。这使 prompt 前缀保持可缓存,从而降低成本。
- 压缩:原始消息历史和工具结果被压缩为密集的观察日志。更小的上下文意味着更快的响应和更长时间内保持连贯的对话。
- 零上下文腐化:agent 看到的是相关信息,而不是嘈杂的工具调用和不相关的 token,这使 agent 在长会话中保持专注。
工作原理工作原理的直接链接
你不会记得自己说过的每一次对话中的每一个字。你在潜意识中观察发生了什么,然后大脑进行反思,重新组织、组合并浓缩为长期记忆。OM 的工作方式与之相同。
每当 agent 响应时,它都会看到一个上下文窗口,其中包含其系统提示、最近消息历史以及任何注入的上下文。上下文窗口是有限的。即使是 token 上限很大的模型,在窗口填满时表现也会变差。这会导致两个问题:
- 上下文腐化:agent 携带的原始消息历史越多,表现越差。
- 上下文浪费:这些历史中的大部分 token 已不再需要用来让 agent 保持专注。
OM 通过将旧上下文压缩为密集的观察记录来解决这两个问题。
观察记录观察记录的直接链接
当消息历史 token 超过阈值(默认:30,000)时,Observer 会创建观察记录,即关于所发生事件的简明笔记:
OM 使用快速的本地 token 估算来完成阈值判断工作。文本使用 tokenx 估算,图像部分使用提供商感知的启发式方法,因此多模态对话仍能在正确的时间触发观察。当传输层将上传的图像规范化为 file 部分而不是 image 部分时,类似的 file 部分也同样适用。例如,OpenAI 的图像细节设置可能会显著改变 OM 决定观察的时机。
Observer 还能看到其审查历史中的附件。为便于阅读,OM 会在转录中保留 [Image #1: reference-board.png] 或 [File #1: floorplan.pdf] 等占位符,同时将实际附件随文本一起转发。在可能的情况下,类图像的 file 部分会变为 Observer 的图像输入。其他附件仍保留为 file 部分并使用规范化后的 token 计数。这适用于普通 thread 观察和批量 resource 作用域观察。
ExtractorsExtractors的直接链接
当你希望 OM 在观察记录之外持久化特定值时,可使用 extractors。内置值使用与自定义值相同的提取流水线。它们包括当前任务和建议响应,以及 thread 标题。
以下示例从观察记录中提取紧凑的用户画像:
import { Agent } from '@mastra/core/agent'
import { Extractor, Memory } from '@mastra/memory'
import { z } from 'zod'

const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'openai/gpt-5-mini',
      observation: {
        extract: [
          new Extractor({
            name: 'User profile',
            instructions: 'Extract stable user profile facts that should be remembered.',
            schema: z.object({
              preferredName: z.string().optional(),
              timezone: z.string().optional(),
              tools: z.array(z.string()).optional(),
            }),
          }),
        ],
      },
    },
  },
})

export const agent = new Agent({
  id: 'assistant',
  name: 'assistant',
  instructions: 'You are a helpful assistant.',
  model: 'openai/gpt-5-mini',
  memory,
})
添加 schema 会使 extractor 作为后续结构化输出请求运行。无 schema 的 extractor 是内联字符串提取器,直接发出在 Observer 或 Reflector 的响应中。
new Extractor({
  name: 'Mood',
  instructions: 'Extract the user mood as a short phrase.',
})
默认情况下,OM 会在后续运行中向 extractor 显示上次提取的值。当 Observer 不应看到先前值时,设置 includePreviousExtraction: false。
new Extractor({
  name: 'Latest blocker',
  instructions: 'Extract any blockers the agent is running into.',
  includePreviousExtraction: false,
})
当 extractor 需要运行时上下文(例如当前 memory 实例或请求上下文)时,可使用运行时 instructions 或 schema 函数:
new Extractor({
  name: 'Workspace summary',
  instructions: ({ memory }) =>
    memory ? 'Extract workspace facts for this memory instance.' : 'Extract workspace facts.',
})
从流中读取提取值从流中读取提取值的直接链接
当 OM 完成一次观察或 reflection 时会发出 extractor 结果。从流中读取两种完成数据部分:
const stream = await agent.stream('Remember that I prefer dark mode.')

for await (const chunk of stream.fullStream) {
  if (chunk.type === 'data-om-observation-end' || chunk.type === 'data-om-buffering-end') {
    const { operationType, extractedValues = {}, extractionFailures = [] } = chunk.data

    for (const [slug, value] of Object.entries(extractedValues)) {
      console.log(`${operationType} extractor ${slug}:`, value)
    }

    for (const failure of extractionFailures) {
      console.error(`Extractor ${failure.slug} failed:`, failure.error)
    }
  }
}
extractedValues 以每个 extractor 的 slug 为键。两个结果字段都是可选的,失败的 extractor 不会移除成功 extractor 的值。
data-om-observation-end 报告同步完成。data-om-buffering-end 报告已完成的后台工作。其 extractor 元数据会立即持久化,但缓冲内容在激活之前保持非活动状态。检查 operationType 可确定已完成的工作是观察还是 reflection。
完整的负载请参阅 data-om-observation-end 和 data-om-buffering-end 参考表。
工作记忆更新工作记忆更新的直接链接
使用 observationalMemory.observation.manageWorkingMemory 让 Observer 自动管理工作记忆。主 agent 在处理用户请求时不再需要调用工作记忆工具,因此工作记忆更新不再依赖 agent 是否记得执行。
这也使工作记忆更利于 prompt 缓存。工作记忆通常位于系统提示中,因此更新可能使 prompt 缓存失效。由 OM 管理的工作记忆默认将 workingMemory.useStateSignals 设为 true,从而将工作记忆移入状态信号。
import { Memory } from '@mastra/memory'

const memory = new Memory({
  options: {
    workingMemory: {
      enabled: true,
    },
    observationalMemory: {
      enabled: true,
      observation: {
        manageWorkingMemory: true,
      },
    },
  },
})
此设置会添加 WorkingMemoryExtractor,将 workingMemory.agentManaged 默认为 false,并将 workingMemory.useStateSignals 默认为 true。如果主 agent 仍应接收工作记忆工具和指令注入,请设置 workingMemory.agentManaged: true。
使用 onExtracted 在自定义提取值持久化之前对其进行规范化或作出反应:
new Extractor({
  name: 'Project status',
  instructions: 'Extract the current project status.',
  schema: z.string(),
  async onExtracted({ current, sendSignal }) {
    await sendSignal?.({
      type: 'user-message',
      contents: `Project status extracted: ${current}`,
    })
    return current.trim().toLowerCase()
  },
})
Extractor 失败会在 OM 标记中报告,不会阻止其他成功的 extractor 值。完整的 Extractor 结构请参阅 API 参考。
如果你的 Observer 模型是纯文本模型或其 API 拒绝多模态输入,请将 observation.observeAttachments 设为 false,在附件到达 Observer 之前将其丢弃。可读的占位符([Image #1: ...]、[File #1: ...])会保留在转录中,因此 Observer 仍能推理共享了什么内容,而无需接收二进制负载。同一过滤器也适用于包含图像或文件部分的工具结果:
new Agent({
  id: 'assistant',
  name: 'assistant',
  instructions: 'You are a helpful assistant.',
  model: 'openai/gpt-5-mini',
  memory: new Memory({
    options: {
      observationalMemory: {
        observation: {
          model: 'deepseek/deepseek-reasoner',
          observeAttachments: false,
        },
      },
    },
  }),
})
你也可以传入 mimeType glob 的允许列表(例如 ['image/*']),仅转发 Observer 能够处理的类型。或者设置 observeAttachments: 'auto',让 Mastra 查询提供商能力注册表。当 Observer 模型支持多模态输入时转发附件,否则丢弃。如果该模型的能力数据不可用,该设置回退为 true。
agent 记录为不可用的附件(因为无法再下载)永远不会发送给 Observer。Observer 仍会看到它们的 [Image #1: ...] 或 [File #1: ...] 行。有关 Mastra 如何记录这些信息,请参阅附件下载失败。
Date: 2026-01-15

- 🔴 12:10 User is building a Next.js app with Supabase auth, due in 1 week (meaning January 22nd 2026)
  - 🔴 12:10 App uses server components with client-side hydration
  - 🟡 12:12 User asked about middleware configuration for protected routes
  - 🔴 12:15 User stated the app name is "Acme Dashboard"
压缩率通常在 5 倍到 40 倍之间。在同步观察期间,Observer 还可以跟踪当前任务和建议响应,以便 agent 从上次中断处继续。
如果启用 observation.threadTitle,当对话主题发生显著变化时,Observer 还可以建议一个简短的 thread 标题。Thread 标题生成需要主动启用,并会更新 thread 元数据,因此像 Mastra Code 这样的应用可以在 thread 列表和状态 UI 中显示最新标题。
示例:使用 Playwright MCP 的 agent 每个页面快照可能会看到 50,000+ 个 token。使用 OM 后,Observer 观察交互并生成几百个 token 的观察记录,描述页面上有什么以及执行了哪些操作。agent 无需携带每个原始快照即可保持专注。
ReflectionsReflections的直接链接
当观察记录超过其阈值(默认:40,000 个 token)时,Reflector 会对其进行浓缩并合并相关条目,同时反思模式。
Reflection 不会作为单独且不断增长的层累积。每次 reflection 都会重写整个观察日志。Reflector 的输出成为新日志,新的观察记录追加在其后。当日志下次达到阈值时,Reflector 会重新处理所有内容,包括早期的 reflection。它会更积极地浓缩较旧的信息,同时保留近期细节。无论对话运行多久,记忆都会在 reflection 阈值附近保持有界。
结果是一个三层系统:
- 最近消息:当前任务的精确对话历史
- 观察记录:Observer 所看到内容的日志
- Reflections:当记忆过长时对观察记录进行浓缩
上下文如何随时间变化上下文如何随时间变化的直接链接
在默认设置下,上下文窗口不会无限增长。它通过观察-收缩循环振荡:
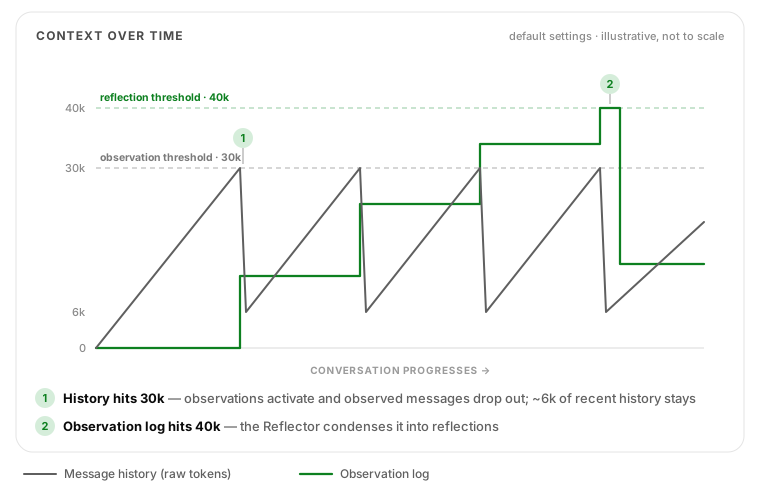
- 0 → 30k token:消息历史正常增长。在后台,Observer 每约 6k token 缓冲一次观察记录(
bufferTokens: 0.2)。 - 达到 30k:已缓冲的观察记录立即激活。被观察的消息从上下文窗口中移除,仅保留约 6k token 的近期历史(
bufferActivation: 0.8保留阈值的 20%)。按典型的 5-40 倍压缩率,被移除的约 24k token 消息会变为大约 1-5k token 的观察记录。 - 重复:历史从约 6k 再次增长到 30k 并再次收缩。每个周期都会追加到观察日志,而观察日志的增长比原始历史慢得多。
- 观察记录达到 40k:Reflector 根据当前观察记录和任何早期 reflection 创建更小的日志。
在正常的缓冲循环中,原始历史大致在 6k 到 30k token 之间振荡。无论对话运行多久,观察日志都保持在约 40k token。这些是激活阈值而非硬性上限,因此当后台缓冲跟不上时,历史可能超过阈值。在阈值和 blockAfter(默认 1.2,约 36k token)之间,缓冲会在后台继续运行,下一个准备好的块会激活而不会阻塞 agent。在 blockAfter 处,如果没有缓冲块激活,则运行同步观察。Reflection 在其自身的 blockAfter(约 48k token)以上回退为同步运行。
启用 shareTokenBudget 后,两个预算会合并使用。当观察日志较小时,消息历史可以扩展到未使用的观察空间(默认设置下最多约 70k token),然后才触发观察。随着观察记录累积,它又会收缩。
检索模式检索模式的直接链接
普通 OM 将消息压缩为观察记录,这非常有利于保持任务专注,但原始措辞消失了。检索模式通过将每个观察组链接到产生它的原始消息来解决这个问题。agent 可以调用 recall 工具来恢复被摘要压缩的源细节,包括确切措辞、工具输出以及时间顺序。
仅浏览仅浏览的直接链接
设置 retrieval: true 可启用 recall 工具以浏览原始消息。无需向量存储。默认情况下,recall 工具可以浏览当前 resource 的所有 thread。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      retrieval: true,
    },
  },
})
结合语义搜索结合语义搜索的直接链接
设置 retrieval: { vector: true } 可同时启用语义搜索。这会复用 Memory 实例上已配置的向量存储和 embedder:
const memory = new Memory({
  storage,
  vector: myVectorStore,
  embedder: myEmbedder,
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      retrieval: { vector: true },
    },
  },
})
配置向量搜索后,新的观察组会在缓冲时和同步观察期间自动建立索引(即发即忘,非阻塞)。语义搜索返回观察组匹配及其原始源消息 ID 范围,因此 recall 工具可以展示摘要记忆及其来源位置。
限制为当前 thread限制为当前 thread的直接链接
默认情况下,recall 工具的作用域为 'resource',agent 可以列出 thread、浏览其他 thread,并在所有对话中搜索。设置 scope: 'thread' 可将 agent 限制为仅当前 thread:
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      retrieval: { vector: true, scope: 'thread' },
    },
  },
})
自定义 recall 指引自定义 recall 指引的直接链接
Mastra 会注入作用域感知的指令,教导 agent 何时搜索、列出 thread 或读取特定 thread。使用 instructions 可在这些内置指令之后追加应用特定的指引。内置指令永远不会被替换:
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      retrieval: {
        vector: true,
        instructions: `
          Prefer the current conversation when it already contains the answer.
          For an initial scan, use a small limit with detail="low".
        `,
      },
    },
  },
})
这使 recall 特定的指引附加到 recall 工具而不是 agent 的全局指令,因此不会影响无关任务。
检索模式启用的能力检索模式启用的能力的直接链接
启用检索模式后,OM 会:
- 在每个观察组上存储一个
range(例如startId:endId),指向其派生自的消息 - 在 agent 的上下文中保持范围元数据可见,使 agent 知道哪些观察记录映射到哪些消息
- 注册一个
recall工具,agent 可以调用它来:- 分页浏览任何观察组范围背后的原始消息
- 按语义相似度搜索(
mode: "search"配合query字符串);需要vector: true - 列出所有 thread(
mode: "threads")、浏览其他 thread(threadId),并在所有 thread 中搜索(默认scope: 'resource') - 当
scope: 'thread'时:将浏览和搜索限制为仅当前 thread
完整 API(细节级别、部分索引、分页、跨 thread 浏览和 token 限制)请参阅 recall 工具参考。
StudioStudio的直接链接
要查看实际效果,请打开 Studio 并导航到启用了 OM 的 agent。Memory 标签页会显示:
-
Token 进度条:消息和观察记录的当前 token 数,显示各自距离阈值有多近。将鼠标悬停在信息图标上可查看 Observer 和 Reflector 的模型与阈值。
-
活动观察记录:当前观察日志内联显示。如果存在早期观察或 reflection 记录,展开"Previous observations"即可浏览。
-
后台处理:在对话期间,随着 agent 在后台处理,会显示已缓冲的观察块和 reflection 状态。
当 agent 正在观察或反思时,进度条会实时更新,显示已用时间和状态徽章。
模型模型的直接链接
Observer 和 Reflector 在后台运行。任何与 Mastra 模型路由(provider/model)兼容的模型都可以使用。未设置模型时,默认为 model: 'auto'。
当配置了 GOOGLE_GENERATIVE_AI_API_KEY 时,自动选择会使用 google/gemini-2.5-flash。否则,它会为当前主模型的提供商选择一个低成本模型,然后回退到当前主模型。Observer 和 Reflector 在每次调用前独立解析。
自动选择会读取主模型的 provider/model ID。由纯模型字符串创建的模型携带该 ID,动态模型函数可以通过返回 { model, id } 为自定义模型添加标签。当 ID 未知时(例如使用自定义 URL、API key、headers 或 gateway 的模型),自动选择会复用主模型本身,因为不知道同提供商的其他模型是否共享该路由。向该角色传入具体模型 ID 可覆盖任一行为。
使用 autoModels 更改提供商所选的模型,使用 resolveModel 以你自己的凭证或路由创建所选模型:
const memory = new Memory({
  options: {
    observationalMemory: {
      autoModels: { openai: 'openai/gpt-5-nano' },
      resolveModel: (modelId, { requestContext }) => createRoutedModel(modelId, requestContext),
    },
  },
})
@mastra/memory 中的 resolveAutoModelId(mainModelId, { autoModels }) 返回自动选择会选中的模型,这适用于在设置 UI 中显示实际生效的模型。
Mastra 建议使用具有大上下文窗口(128K+ token)且速度足够快、能在后台运行而不拖慢操作的模型。
要固定模型,请设置具体模型 ID。我们还成功测试了 openai/gpt-5-mini、anthropic/claude-haiku-4-5、deepseek/deepseek-reasoner、deepseek/deepseek-v4-pro、deepseek/deepseek-v4-flash、xai/grok-4-1-fast、qwen3 和 glm-4.7。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'deepseek/deepseek-reasoner',
    },
  },
})
为每个 agent 使用不同模型请参阅模型配置。
google/gemini-2.5-flash 在保留长输出细节方面异常出色。因此,即使经过最大压缩重试,Reflector 生成的 reflection 仍可能超过配置的 reflection.observationTokens 阈值。发生这种情况时,Reflector 会返回重试期间产生的最小非退化候选,使循环终止而不是永远运行。
如果你希望 Reflector 进行更激进的压缩,可以换用更容易浓缩的模型,例如 xai/grok-4-1-fast、deepseek/deepseek-v4-pro 或 deepseek/deepseek-v4-flash。你可以为 Observer 保留 google/gemini-2.5-flash,并为 Reflector 使用不同模型。参见每个 agent 使用不同模型。
按 token 分层选择模型按 token 分层选择模型的直接链接
新增于: @mastra/memory@1.10.0
你可以使用 ModelByInputTokens 根据输入 token 数为 Observer 或 Reflector 指定不同的模型。OM 会在运行时从配置的 upTo 阈值中选择匹配的模型层级。
import { Memory, ModelByInputTokens } from '@mastra/memory'

const memory = new Memory({
  options: {
    observationalMemory: {
      observation: {
        model: new ModelByInputTokens({
          upTo: {
            // Faster, cheaper models for smaller inputs; stronger models for larger contexts
            5_000: 'openrouter/mistralai/ministral-8b-2512',
            20_000: 'openrouter/mistralai/mistral-small-2603',
            40_000: 'openai/gpt-5-mini',
            1_000_000: 'google/gemini-3.1-flash-lite-preview',
          },
        }),
      },
      reflection: {
        model: new ModelByInputTokens({
          upTo: {
            20_000: 'openai/gpt-5-mini',
            100_000: 'google/gemini-2.5-flash',
          },
        }),
      },
    },
  },
})
upTo 的键是包含式上限。OM 会计算 Observer 或 Reflector 调用的实际输入 token 数,并直接解析匹配的层级,同时对该次运行使用该具体模型。
如果输入超过配置的最大阈值,则会抛出错误。请确保阈值覆盖所有可能的输入大小,或在最高层级使用上下文窗口足够大的模型。
作用域作用域的直接链接
Thread 作用域(默认)Thread 作用域(默认)的直接链接
每个 thread 拥有自己的观察记录。该作用域经过充分测试,适合作为通用记忆系统,尤其适用于长期 agentic 用例。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      scope: 'thread',
    },
  },
})
Thread 作用域要求在调用 agent 时提供有效的 threadId。如果缺少 threadId,Observational Memory 会抛出错误。这可以防止多个 thread 静默共享同一条观察记录,从而避免数据库死锁。
Resource 作用域(已弃用)Resource 作用域(已弃用)的直接链接
scope: 'resource' 已弃用,并将在未来版本中移除。首次以 resource 作用域创建 Observational Memory 时,Mastra 会记录一条警告。移除 scope 选项以使用默认的 thread 作用域,并使用下方的替代方案实现跨对话连续性。
在 resource 作用域中,观察记录在某个 resource(通常是用户)的所有 thread 之间共享。对于 prompt 缓存和 agent 对对话的理解,resource 作用域的效果远不如 thread 作用域:
- Prompt 缓存: 每个 thread 的观察记录共享一条记录。当任何 thread 被观察时,观察上下文都会对所有其他 thread 发生变化,从而使它们的缓存 prompt 前缀失效。
- Agent 理解: 每个 thread 都会看到该 resource 所有 thread 的观察记录混合。每个新 thread 都从早期 thread 的上下文开始,agent 可能会继续另一个 thread 已开始但未完成的工作。
- 所有 thread 中未观察的消息会一起处理,对于拥有许多现有 thread 的用户来说速度很慢。
一个用于跨 thread 记忆的新的知识和潜意识记忆原语即将推出,并将取代 resource 作用域。在此之前,请使用下方的替代方案。
不使用 resource 作用域的跨 thread 连续性不使用 resource 作用域的跨 thread 连续性的直接链接
从 resource 作用域切换到 thread 作用域不会迁移 resource 作用域的观察记录。每个 thread 如果有现有的 thread 作用域记录,则使用该记录;否则以一个新的空记录开始。已在 resource 作用域下观察过的消息不会再次被观察。必须延续的事实请保留在 resource 作用域工作记忆中。
请改用 thread 作用域,并结合以下一项或两项功能:
- 检索模式:agent 获得一个
recall工具,可以列出并浏览同一 resource 的其他 thread,并可选地对其进行语义搜索。agent 仅在需要时查找先前的对话。 - Resource 作用域工作记忆:存储关于用户的小型持久事实,每个 thread 都可以读取。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      retrieval: true,
    },
    workingMemory: {
      enabled: true,
      scope: 'resource',
    },
  },
})
Token 预算Token 预算的直接链接
OM 使用 token 阈值来决定何时观察和反思。详情请参阅 token 预算配置。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      observation: {
        // when to run the Observer (default: 30,000)
        messageTokens: 30_000,
      },
      reflection: {
        // when to run the Reflector (default: 40,000)
        observationTokens: 40_000,
      },
      // let message history borrow from observation budget
      // requires bufferTokens: false (temporary limitation)
      shareTokenBudget: false,
    },
  },
})
Token 计数缓存Token 计数缓存的直接链接
OM 将 token 估算缓存在消息元数据中,以减少阈值检查和缓冲决策期间的重复计数工作。
- 各部分的估算存储在
part.providerMetadata.mastra上,当缓存版本/tokenizer 来源匹配时,在后续处理中复用。 - 对于仅字符串的消息内容(无 parts),OM 使用消息级元数据回退缓存。
- 消息和对话开销每次处理时仍会重新计算。缓存仅存储负载估算,因此计数语义保持不变。
data-*和reasoning部分仍会被跳过且不会被缓存。
调用方为 file 部分提供的 token 估算调用方为 file 部分提供的 token 估算的直接链接
你可以使用 providerMetadata.mastra.tokenEstimate 将 token 估算直接附加到 image 或 file 部分。Token Counter 会原样采用该值并跳过自己的估算器:
const filePart = {
  type: 'file',
  data: 'storage://bucket/large-report.pdf',
  mimeType: 'application/pdf',
  filename: 'large-report.pdf',
  providerMetadata: {
    mastra: {
      tokenEstimate: {
        v: 0,
        source: 'client',
        key: 'client',
        tokens: 100_000,
      },
    },
  },
}
tokenEstimate 对象采用与 Token Counter 内部缓存估算相同的结构:
v:缓存 schema 版本。设置为0。调用方提供的条目不受框架版本检查约束,因此不会读取该值。source:缓存来源标记。必须为'client'。它告诉 Token Counter 该条目是权威的,应原样采用,而不是重新计算或覆盖。key:内容指纹槽位。设置为'client'。框架条目在此使用内容哈希,以便在负载变化时失效。'client'哨兵值使调用方估算在多次写入间保持稳定。tokens:要使用的 token 数。必须是有限非负数。
补充说明:
- 估算仅在
image和file部分上生效。text和tool-invocation部分始终正常计数,即使它们携带tokenEstimate。
异步缓冲异步缓冲的直接链接
没有异步缓冲时,Observer 在达到消息阈值时同步运行,agent 会在对话中途暂停,等待 Observer 的 LLM 调用完成。启用异步缓冲(默认启用)后,观察记录会随着对话增长在后台预先计算。当达到阈值时,已缓冲的观察记录会立即激活,无需暂停。
工作原理工作原理的直接链接
随着 agent 对话,消息 token 会累积。每隔一定间隔(bufferTokens),后台 Observer 调用会在不阻塞 agent 的情况下运行。每次调用都会产生一个观察记录"块",存储在缓冲区中。
当消息 token 达到 messageTokens 阈值时,缓冲块会激活:其中的观察记录移入活动观察日志,相应的原始消息从上下文窗口中移除。agent 永不暂停。
异步缓冲的 Observer 调用不会生成继续提示,因为延迟的提示在激活时可能已过时。当缓冲块激活时,先前存储的建议响应和当前任务会被清除。主 agent 接收压缩后的观察记录,但不包含这些提示。
当消息产生速度快于 Observer 时,历史可能在缓冲块准备好之前就超过 messageTokens。在 messageTokens 和 blockAfter 之间,Mastra 会在后台继续缓冲并在之后的步骤激活块,因此 agent 不会等待 Observer。如果在缓冲激活后待处理 token 仍达到 blockAfter(例如大型工具结果留下了未覆盖的尾部),则会运行同步观察。在 blockAfter 以上,激活还可能超出保留目标,而不是使用更少的块。缓冲激活通常保留最少的剩余上下文(约 1k token 或配置的保留下限中的较小者),但覆盖整个待处理窗口的单个缓冲块仍会激活,并可能留下更少上下文。
在 blockAfter 处,激活会等待仍在生成的缓冲观察一段有限时间,以便它与其余部分一起激活。如果耗时更长,Mastra 会同步观察剩余消息。随后,一条其消息均已被观察的迟到观察会被丢弃而不是存储。由空闲 TTL 或模型变更触发的激活不会等待。
Reflection 的工作方式类似:当观察记录达到 reflection 阈值的一定比例时,Reflector 在后台运行。
设置设置的直接链接
| 设置 | 默认值 | 控制内容 |
|---|---|---|
observation.bufferTokens | 0.2 | 缓冲频率。0.2 表示每达到 messageTokens 的 20%。在默认 30k 阈值下,约为每 6k token。也可以是绝对 token 数(例如 5000)。 |
observation.bufferActivation | 0.8 | 激活时清除消息窗口的积极程度。0.8 表示移除足够多的消息,只保留 messageTokens 的 20%。较低的值保留更多消息历史。 |
observation.blockAfter | 1.2 | 缓冲跟不上时的安全网。1 到 100(不含)之间的值会乘以 messageTokens。例如,1.2 创建 36k token 的阈值(1.2 × 30k)。低于该值时,只运行后台缓冲和激活。如果在缓冲激活后待处理 token 仍达到该值,则同步运行观察。激活也可能超出保留目标。100 及以上的值是绝对 token 数(例如 50_000),必须大于 messageTokens。设为 1 可在 messageTokens 处同步观察。 |
activateAfterIdle | 无 | 在一段时间不活动后强制激活已缓冲的观察记录,即使尚未达到 observation.messageTokens。接受数值毫秒(例如 300_000)、时长字符串如 "5m" 或 "1hr"、"auto"(提供商感知的 prompt 缓存 TTL),或按提供商设置 TTL 的对象,例如 { default: 'auto', anthropic: '1h' }。 |
activateOnProviderChange | false | 当下一步使用的 provider/model 与产生最新 assistant 步骤的模型不同时,强制激活已缓冲的观察记录。在切换提供商或模型会使 prompt 缓存复用失效时使用。 |
reflection.bufferActivation | 0.5 | 何时开始后台 reflection。0.5 表示当观察记录达到 observationTokens 阈值的 50% 时开始 reflection。 |
reflection.activateAfterIdle | 无 | 让已缓冲的 reflection 选择启用空闲激活。Reflection 不继承顶层 activateAfterIdle。 |
reflection.activateOnProviderChange | false | 让已缓冲的 reflection 选择启用提供商变更激活。Reflection 不继承顶层 activateOnProviderChange。 |
reflection.blockAfter | 1.2 | Reflection 的安全阈值。值的格式与观察相同(绝对值必须大于 observationTokens),但超过该值时,如果没有准备好的缓冲 reflection 可激活,则同步运行 reflection。 |
如果你依赖 prompt 缓存,请将 activateAfterIdle 设为 "auto" 或特定的缓存 TTL。这样,一旦 thread 空闲足够长以致缓存过期,下一个请求就可以先激活已缓冲的观察记录,并发送更小的压缩上下文窗口。
使用 "auto" 时,Mastra 会根据当前模型提供商选择空闲激活 TTL:
| 提供商 | 自动 TTL |
|---|---|
| Anthropic、OpenRouter、未知提供商、xAI | 5 分钟 |
| DeepSeek | 1 小时 |
| Google Gemini | 24 小时 |
| Groq | 2 小时 |
OpenAI 且 providerOptions.openai.promptCacheRetention: "24h" | 1 小时 |
OpenAI 且 providerOptions.openai.promptCacheRetention: "in_memory" | 5 分钟 |
OpenAI gpt-4*、gpt-5、gpt-5-* 以及 gpt-5.1 到 gpt-5.4(含带 - 后缀的变体) | 5 分钟 |
| 其他 OpenAI 模型 | 1 小时 |
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      activateAfterIdle: 'auto',
      activateOnProviderChange: true,
    },
  },
})
使用 "auto" 时,这会根据当前提供商的 prompt 缓存行为激活已缓冲的观察记录,以便下一个未缓存的 prompt 使用压缩后的观察记录,而不是更大的原始消息窗口。如果你希望固定的 5 分钟 TTL,请使用 "5m" 或 300_000。
在线程中途更改模型或提供商会使 prompt 缓存失效。如果你的 agent 可能在线程中途切换提供商或模型,activateOnProviderChange: true 会强制在新提供商运行前激活已缓冲的观察记录。这避免向无法复用先前 prompt 缓存的提供商发送大型原始窗口。
按提供商的空闲 TTL按提供商的空闲 TTL的直接链接
"auto" 无法看到你在单条消息上设置的缓存 TTL,例如 Anthropic 的 cacheControl: { type: 'ephemeral', ttl: '1h' }。它会继续使用提供商的 5 分钟默认值,因此缓冲的观察记录会在 1 小时缓存仍有效时激活。改为传入一个对象来按提供商设置 TTL:
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      activateAfterIdle: { default: 'auto', anthropic: '1h' },
    },
  },
})
将 anthropic 条目设为与 cacheControl.ttl 相同的 TTL。Mastra 不会读取单条消息的缓存设置,因此必须手动保持两者同步。
对象的解析方式:
- 键是提供商名称。Mastra 会将其与模型提供商在第一个
.之前的部分进行不区分大小写的比较,因此anthropic同时匹配anthropic和anthropic.messages。通过其他提供商提供的 Claude 使用该提供商的键,例如amazon-bedrock。键不得包含.或/。 - 每个值接受与单个 TTL 相同的形式:毫秒、时长字符串、
"auto",或false以关闭该提供商的空闲激活。 default适用于所有没有自己键的提供商。如果没有default,这些提供商不会进行空闲激活。observation.activateAfterIdle和reflection.activateAfterIdle接受相同的对象。observation.activateAfterIdle对象会替换顶层值,而不会与之合并。
禁用禁用的直接链接
要禁用异步缓冲并改用同步观察/reflection:
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      observation: {
        bufferTokens: false,
      },
    },
  },
})
设置 bufferTokens: false 会同时禁用观察和 reflection 的异步缓冲。完整 API 请参阅异步缓冲配置。
Resource 作用域(已弃用)会自动禁用异步缓冲。
Observer 上下文优化Observer 上下文优化的直接链接
默认情况下,Observer 在处理新消息时会接收完整的观察历史作为上下文。Observer 还会接收先前的 current-task 和 suggested-response 元数据(如果可用),因此即使观察上下文被截断,它也能保持方向。对于观察记录变得很大的长对话,你可以选择启用上下文优化以降低 Observer 输入成本。
设置 observation.previousObserverTokens 可限制发送给 Observer 的先前观察 token 数。观察记录会从尾部截断,保留最近的条目。当有缓冲 reflection 待处理时,已反思的行会在应用截断前自动替换为 reflection 摘要。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      observation: {
        previousObserverTokens: 10_000, // keep only ~10k tokens of recent observations
      },
    },
  },
})
previousObserverTokens: false→ 默认。发送完整的先前观察记录。previousObserverTokens: 2000→ 保留约 2k token 的近期观察记录。previousObserverTokens: 0→ 完全省略先前观察记录。
HooksHooks的直接链接
OM 在 observationalMemory.hooks 上暴露两类配置级 hook:
- 生命周期 hook(
onObservationStart、onObservationEnd、onReflectionStart、onReflectionEnd)是遥测回调。它们接收threadId、resourceId和trigger,结束 hook 还会接收模型调用的usage、providerMetadata以及任何error。它们永远不会改变 OM 存储的内容。 - Transform hook(
beforeObservation、afterObservation、beforeReflection、afterReflection)拦截流经周期的数据。返回void表示原样传递输入,或返回替换内容以更改 Observer/Reflector 看到的内容或持久化的内容。
const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      hooks: {
        // Drop or redact messages before the Observer sees them.
        beforeObservation: ({ messages }) => ({
          messages: messages.filter(m => !isSensitive(m)),
        }),
        // Rewrite observations before they are persisted.
        afterObservation: ({ observations, threadId }) => ({
          observations: redact(observations),
        }),
        // Rewrite the text the Reflector condenses, or its output.
        beforeReflection: ({ observations }) => ({
          observations: stripInternalNotes(observations),
        }),
        afterReflection: async ({ observations, resourceId }) => {
          await syncToExternalStore(resourceId, observations)
        },
      },
    },
  },
})
Transform hook 在所有路径上都会被等待(手动 observe()/reflect()、回合同步观察以及异步缓冲)。如果 beforeObservation 返回空的 messages 数组,则跳过 Observer 模型调用,被过滤的消息仍会被标记为已观察。如果 transform hook 抛出错误,周期会在提交转换后的观察或 reflection 文本之前失败。这不会回滚已运行的 extractor 回调或其他副作用。
afterObservation 和 afterReflection 仅替换观察或 reflection 文本。它们不会重新计算或脱敏存储在 thread 元数据中的单独结构化 extractor 结果。Reflection 提取及其回调在 afterReflection 之前运行,因此重写 reflection 不会重新运行这些回调。使用 extractor 配置和回调控制结构化值。不要将 after hook 视为所有周期数据的脱敏边界。
由于 hook 接收 threadId 和 resourceId,你还可以在周期中通过 memory.updateWorkingMemory() 用它们更新工作记忆。这些外部更新与 OM 文本提交不是原子的。
脱敏 skill 结果脱敏 skill 结果的直接链接
Agent skills 作为工具(skill、skill_search、skill_read)注入到 agent 中。它们的结果包含 skill 的完整指令或文件内容,因此如果不脱敏,Observer 每次使用 skill 时都会重新观察该文本。skillResultRedactor() 是一个现成的 beforeObservation hook,它会将这些结果替换为占位符,其他内容保持不变。工具调用仍然保留,因此 Observer 仍会记录使用了哪个 skill 以及调用参数。
import { Memory } from '@mastra/memory'
import { skillResultRedactor } from '@mastra/memory/hooks'

const memory = new Memory({
  options: {
    observationalMemory: {
      model: 'google/gemini-2.5-flash',
      hooks: {
        beforeObservation: skillResultRedactor(),
      },
    },
  },
})
传入 toolNames 可脱敏另一组工具的结果。由于 hook 是作用于消息的函数,它可以通过链接输出与你自己的 transform 组合。请等待每个链式 hook,以免异步 hook 被丢弃:
const dropSkillResults = skillResultRedactor()

hooks: {
  beforeObservation: async input => {
    const messages = (await dropSkillResults(input))?.messages ?? input.messages
    return { messages: messages.filter(m => m.role !== 'signal') }
  },
}
迁移现有 thread迁移现有 thread的直接链接
无需手动迁移。OM 会读取现有消息,并在超过阈值时惰性观察它们。
- Thread 作用域:thread 首次超过
observation.messageTokens时,Observer 会处理积压消息。 - Resource 作用域(已弃用):resource 的所有 thread 中所有未观察的消息会一起处理。对于拥有许多现有 thread 的用户,这可能需要大量时间。
OM 与其他记忆功能的比较OM 与其他记忆功能的比较的直接链接
- 消息历史:当前对话的高保真记录
- 工作记忆:用于用户偏好、姓名、目标的小型结构化状态(JSON 或 markdown)
- 语义召回:基于 RAG 的相关历史消息检索
- 多用户 thread:当多人共享单个 thread 时,OM 如何将事实归属到各个用户
如果你正使用工作记忆存储对话摘要或随时间增长的状态,OM 是更合适的选择。工作记忆用于小型结构化数据。OM 用于长期运行的事件日志。OM 还会自动管理消息历史,messageTokens 设置控制观察运行前保留多少原始历史。
实际上,OM 同时取代了工作记忆和消息历史,并且比语义召回更准确(成本也更低)。
相关内容相关内容的直接链接
- Observational Memory 参考
- Memory 概览
- 消息历史
- Memory processors
- Mastra Code:使用 Observational Memory 的编码 agent
- 📹 Mastra processors 与 Observational Memory 研讨会